

大模型网关技术栈拆解:从负载均衡到可观测性的工程实践
发布日期: 2026-10-13作者: 犀犀来源: 犀思云浏览: 3
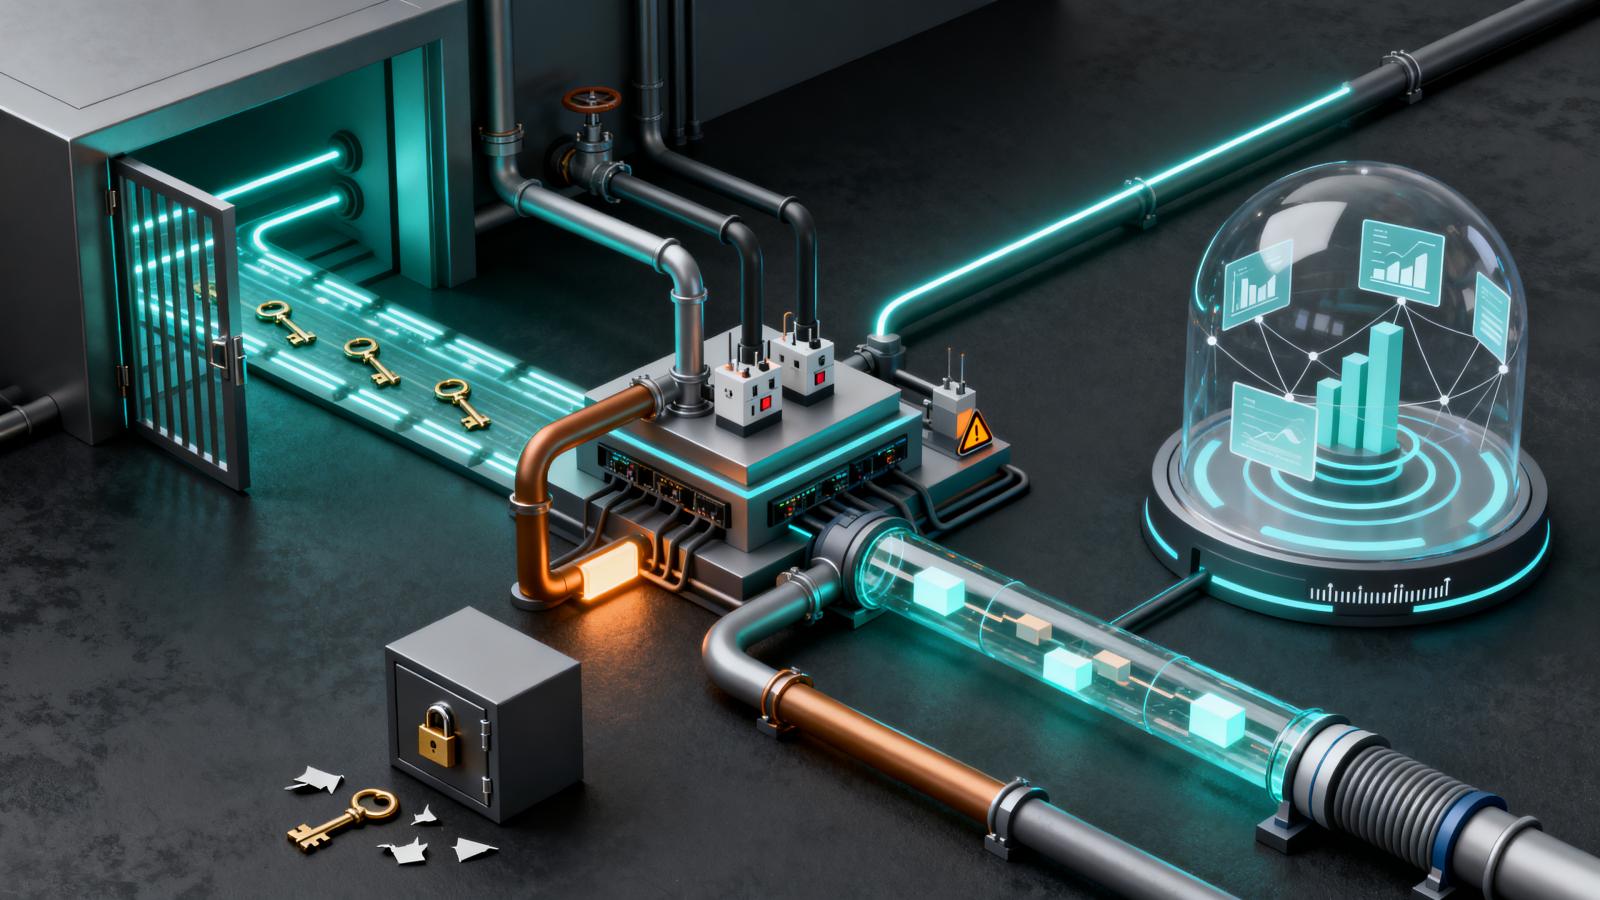
某业务团队把大模型 API Key 硬编码进代码仓库,部署到生产环境。供应商安全扫描判定凭证疑似泄露后直接吊销,当天下午全线业务报错,运维排查数小时才定位到根因。这个现场复盘暴露的,不是模型接口调不通,而是大模型网关缺失之后,密钥、配额、成本、审计四件事同时失控。本文不做模型选型对比,只拆技术栈:负载均衡、鉴权、限流、熔断、可观测性,适合 AI 工程团队、平台架构师、SRE/DevOps 及技术决策者阅读。判断与架构分层依据多篇公开技术文档,具体来源列表见文末「参考来源」。
一、大模型网关的技术定位:为什么不是"换了皮的 API 网关"
1. 问题界定:大模型网关解决的不是"能不能调通",而是"怎么管、怎么控、怎么看"
单个模型做 Demo 时,直接调官方接口完全够用。进入多模型规模化阶段后,情况变化明显:密钥散落在 Git 仓库、本地环境变量和 CI 流水线里;业务方各自绑定不同供应商,接口规范、签名逻辑、流式响应格式互不兼容;几十个 Key 各自付款,账单无法归因到项目;测试任务死循环调用一整天,多出数万元的 Token 消耗无人在入口拦截。
大模型网关作为上下文感知的治理中间件,承担的不是单纯 HTTP 转发。它需要理解 Token 计量、模型路由策略、流式协议与 Prompt 语义,把分散的模型使用行为收敛成可管理、可控制、可观测的统一入口。
2. 与 API 网关的边界辨析
传统 API 网关把请求当作同质流量处理,关心路径匹配、方法转发、状态码。大模型网关和 API 网关的区别,在于前者必须理解请求语义:一个 POST 请求消耗多少 Token、应该路由到哪个模型供应商、响应是 SSE 事件流还是完整 JSON、单租户的 Token 消耗量是否已逼近配额上限。
可以这样定位:API 网关管的是 HTTP 流量,大模型网关管的是模型使用行为。前者解决转发效率,后者解决治理深度。
3. 分层架构总览:问题→模块映射
完整的技术栈可以按请求生命周期分为五层:流量接入层负责统一鉴权与密钥隔离;路由与负载均衡层负责多模型流量分发;流式协议适配层负责 SSE 连接管理与缓冲策略;治理策略层负责限流与熔断;可观测性层负责链路追踪、指标采集与成本归因。下文按这个顺序逐一展开。
二、流量接入层:统一鉴权与密钥隔离
1. 从密钥散落到统一凭证管理的工程落地
大模型网关密钥统一管理方案的核心,是切断真实模型密钥与业务代码的直接接触。对内,网关向应用暴露 app_id / api_key;对外,网关持有真实模型密钥并动态映射。业务代码只认网关凭证,真实密钥不出网关边界。
密钥与代码库、环境变量、CI 流水线解耦之后,签名逻辑、权限校验、来源识别全部收敛到网关侧完成。供应商密钥轮换时,业务应用无感知,只需要在网关配置中更新一次。
2. 多租户身份模型设计
生产环境建议采用四层身份标识:租户 → 应用 → 用户 → 会话。租户是隔离边界,配额、权限、路由策略都以租户为单位设置。应用是调用主体,每个应用拿到独立的 app_id/api_key。用户和会话用于细粒度审计追溯。
权限最小化原则在网关层落地为:每个应用只能获取分配到的最小模型权限集合,应用 A 无权调用分配给应用 B 的模型资源。租户级的配额耗尽,只影响该租户自身的调用,不波及其他租户。
3. 审计追溯的切入点:凭证使用轨迹
统一接入层天然形成一个完整审计点。请求进入网关的瞬间,谁、何时、调什么、消耗多少就在入口被记录。这条凭证使用轨迹与后文的合规审计章节形成呼应,为审计日志提供了最上游的数据来源。
三、负载均衡与路由:多模型流量分发策略
1. 大模型网关的负载均衡与传统七层负载的本质差异
常规七层负载均衡依据连接数、响应时间、节点健康状态来分配流量。大模型网关的负载均衡需要叠加额外维度:模型服务商配额余量、Token 成本价格、流式会话持有连接数、上下文窗口长度。
举例来说,供应商 A 在当月的额度只剩余 10 万个 Token,而供应商 B 单价更低且余量充足。如果负载均衡只按连接数分配,流量仍会被打入即将耗尽的通道。模型路由的决策必须实时融合配额与成本信号。
2. 路由策略的分类
静态路由基于应用配置固定映射到指定供应商,适合模型能力与业务场景一一对应的稳定场景。动态路由基于配额余量、成本水位、可用性健康度实时选择,适合多供应商备选、价格波动敏感的生产环境。语义路由按任务特性分派,生成类任务走高性能模型,摘要与编辑类任务走成本更低的轻量模型。
3. 多供应商故障隔离与容错设计
下游超时时,网关需要切换备用供应商而不是直接报错。这个切换决策与熔断器状态紧密耦合,熔断器先判定故障,路由层再选择降级路径。业界常见实现形态参考 Spring Cloud Gateway 配合 Nginx 反向代理,Nginx 处理四层负载与权重轮询,Spring Cloud Gateway 处理应用层路由与过滤逻辑。
四、流式代理的工程深水区:SSE 线程模型与缓冲策略
1. 为什么流式响应是网关真正的工程难点
传统 API 请求-响应是一次性同步交互,后端返回完整结果,连接结束。SSE 流式响应完全不同:它是有状态的长连接,上游模型持续推送事件流,下游客户端持续接收,两端连接都需要网关同时维护,同时还要处理双向背压。
这就是流式代理怎么实现的核心难题。不同供应商对 SSE 流的实现差异明显,有的流结束发 [DONE],有的发自定义事件,有的中途断连不给错误码。网关必须消除这些差异,对上层暴露统一格式。
2. 线程模型选型
同步阻塞模型下,单个流式会话占用一个线程,连接持续时长等于模型完整生成时长。高并发场景中,线程池会迅速枯竭。异步非阻塞模型允许少量线程支撑大量并发流式会话,线程在等待上游推送事件时释放,事件到达时再恢复处理。
事件驱动模型(如 Reactor)在流式场景下适配度更高:连接生命周期、事件推送、背压信号都被抽象为事件,由事件循环统一调度,避免了线程切换开销和阻塞风险。
3. 缓冲策略的权衡
完全缓冲策略等上游完整响应后统一返回,实现简单,但首字节延迟随生成长度线性增长,用户等待感明显。逐 token 流式转发首字节延迟最低,但上游速率波动和下游网络抖动都会被逐级传导。
混合策略按固定事件块缓冲,例如每累积 N 个 token 或每 50ms 刷新一次,在首字节延迟与连接稳定性之间取得平衡。生产环境多数采用这种折中方案。
4. 背压机制
上游模型生成速度快于下游客户端消费速度时,网关侧会积累未消费事件。网络波动导致客户端响应缓慢时,如果上游持续推送,内存会被挤压。网关侧需要引入队列缓冲加水位线控制:低水位时正常接收,高水位时向上游施加背压信号,水位回落时恢复。
背压协议的实现层级不同:TCP 窗口缩减依靠传输层机制,应用层暂停则需要在网关与上游连接间显式控制读取速率。
五、限流与熔断:多租户配额与故障隔离
1. 三层限流维度
大模型网关限流熔断实现方式不能简化为每分钟请求数。有效限流覆盖三个独立维度:请求数、并发流式会话数、单租户 Token 消耗量。请求数限流防止调用频率异常,并发流式会话数限流防止长连接积累导致资源耗尽,Token 消耗量限流与控制成本直接挂钩,是大模型网关特有的维度。
三个维度相互独立又共同构成配额体系。租户可以请求频率正常,但单次消耗 Token 极大,只有 Token 消耗量限流才能兜底。
2. 主流限流算法在网关场景的适用性
令牌桶算法提供平滑的突发处理能力,适合大模型调用中偶发的批量请求峰值。Redis + Lua 实现分布式令牌桶是多实例网关场景的常见落地方式,原子性由 Lua 脚本保证。滑动窗口计数器精度较高但内存开销随窗口粒度增长,适用于对精确度要求高的租户配额场景。
3. 熔断降级的触发与恢复
熔断触发信号通常包含:响应超时、上游 5xx 错误率超过阈值、供应商频次保护触发。熔断后的降级路径按优先级排列:自动切备用供应商、返回友好错误码、记录故障上下文用于事后分析。
半开状态下的试探性恢复策略是:熔断一段时间后放行少量探测请求,如果探测成功则逐步恢复流量,如果失败则继续保持熔断并延长冷却时间。
六、可观测性闭环:从链路追踪到 Token 级成本归因
1. 全链路 Trace 的父子 span 结构设计
一次大模型请求的完整调用链包含:网关入口 → 鉴权 → 路由 → 上游模型 → 流式转发 → 响应回写。每条 span 记录关键 annotation:请求 ID、租户 ID、模型名称、Token 消耗、首字节时间、完整耗时。
链路追踪与日志、指标通过统一的请求 ID 关联,运维定位问题时可以从一条 Trace 检索到关联日志和对应时段的指标变化。
2. 指标采集与告警维度
大模型网关可观测性设计思路需要覆盖的核心指标包括:请求量、失败率、平均首字节延迟、P99 完成耗时、Token 吞吐量、缓存命中率。这些指标共同描绘网关和上游供应商的健康状态。
告警分级应区分故障范围:供应商级故障告警单一路由通道的相关团队,租户级配额耗尽告警业务负责人。告警疲劳治理需要设置收敛规则,相同根因的告警合并发送,抑制重复通知。
3. Token 级成本归因的技术实现
Token 成本归因怎么做,不能把总费用按请求数平均分摊。不同模型单价差异数倍,同一句话在不同模型上的 Token 消耗量也不同。归因必须与链路 Trace 绑定,从 trace 的 usage 字段中提取每次请求的实际 Token 消耗。归因数据模型以租户/应用/模型/日期四维度聚合。
工程落点在网关侧统一计量 Token,而不是依赖各供应商账单事后对账。网关在响应流中解析 usage 字段,实时写入归因存储。供应商账单只能验证网关计量是否准确,不能替代网关作为实时成本数据源。这一设计让项目真实成本可被核算,预算与配额形成闭环管理。
4. 成本归因与容量规划的联动
Token 消耗趋势分析可指引供应商配额采购决策,避免按峰值盲目采购造成闲置。为不同业务线设定差异化成本水位线之后,超线告警与限流策略联动,从被动对账转向主动控制。部分 NaaS 服务商已经提供网关成本可视化方案,按租户维度展示实时 Token 消耗与预算使用进度,可作为容量规划的参考形态。
七、合规审计视角:统一审计点设计
1. 为什么金融、政务场景绕不开统一审计点
多模型分散直连意味着没有一条完整的审计链。模型调用记录散落在各业务系统和供应商后台,格式互不兼容,无法回答一次具体调用从哪里来、消耗了什么。统一网关天然成为所有模型调用的必经点,具备完整留痕能力,审计数据在入口即被完整采集。
2. 审计日志的内容要素
完整审计日志至少包含四个维度。谁:租户 ID、应用 ID、用户标识。何时:请求时间戳、响应时间戳、首字节时间。什么:模型名称、请求参数(脱敏后)、Token 消耗。结果:成功、失败或熔断降级的具体状态。这些要素共同支撑事后回放和定位责任方。
3. 合规审计的技术实现边界
审计日志的存储周期需满足行业监管要求,具体时长以适用规范为准。请求参数写入前需完成脱敏处理,敏感字段不可明文落盘。审计日志与业务日志应隔离存储,访问审计日志本身也需要权限控制。审计数据的不可篡改性设计可通过只追加写入、完整性校验等机制实现。
常见问题解答
大模型网关和 API 网关有什么区别?
API 网关管 HTTP 流量,大模型网关管模型使用行为。前者关心路径转发和协议转换,后者必须理解 Token 计量、流式协议、模型路由策略和租户配额。两者的差异不在转发能力,而在治理深度。
流式代理为什么不能用传统的 HTTP 代理方式实现?
传统 HTTP 代理假设请求-响应是一次性同步交互,连接生命周期短。SSE 流式响应是有状态长连接,上游持续推送事件流,网关需要同时维护两端连接并处理背压。用同步阻塞模型处理流式会话,线程池会被长连接迅速占满。
Token 级成本归因的关键实现点是什么?
关键实现点是在网关侧统一计量 Token,而非依赖供应商账单事后对账。归因数据必须与链路 Trace 绑定,从 trace 的 usage 字段提取实际消耗,按租户/应用/模型/日期四维度聚合。
多模型场景下密钥统一管理应该怎么做?
网关对内暴露 app_id/api_key,对外持有真实模型密钥并动态映射。真实密钥不出网关边界,业务代码只认网关凭证。密钥轮换在网关统一完成,业务应用不感知。
小团队需要自己搭建大模型网关吗?
如果模型调用量小且供应商单一,直接调官方接口即可。当多供应商接入、需要 Token 成本归因或面临合规审计要求时,建议考虑自建或采用成熟的网关服务,把治理能力前置而不是等失控后补救。
参考来源
大模型网关定义与六大评估维度:https://www.163.com/dy/article/L6IBGA060556P9B8.html
Spring Cloud Gateway 流式代理实战:https://blog.csdn.net/weixin_29698641/article/details/164774411
企业级网关分层架构与协议适配:https://segmentfault.com/a/1190000048285096
密钥泄露案例与痛点归纳:https://blog.csdn.net/weixin_32175665/article/details/164605367
多模型直连失控案例:https://blog.csdn.net/weixin_30225755/article/details/164763168
负载均衡与熔断配置参考:https://cloud.baidu.com/article/3723416
五方案选型对比:https://cloud.tencent.com/developer/article/2680813
本文由犀思云技术团队撰写,含相关产品服务信息,仅供技术交流。
