

为什么大模型应用成本难控?大模型网关帮你管好路由与配额
发布日期: 2026-10-13作者: 犀犀来源: 犀思云浏览: 3
大模型应用上线后,CTO 最怕收到的不是模型能力评测,而是月底那封账单邮件:环比涨了 3 倍,财务追问钱花在哪,工程团队只能说“大概是某个 AI 助手在跑”。这不是单个团队的问题。腾讯云 AI 网关团队走访数十家生产客户后发现,账单暴涨背后是同一套结构性漏洞的多种表现。本文要回答的是:为什么大模型应用成本难控,以及大模型网关如何通过路由与配额两个抓手,把模型调用从“事后挨骂”变成“事前管控”。
一、大模型应用成本难控,到底难在哪里
成本失控的原因不在模型本身,而在接入方式、计量方式和降级机制三条线上同时缺位。拆开看,大模型应用成本难控原因集中在三个方面。
1. 多模型接入碎片化,各团队各自为政
典型企业同时接入四家外部模型服务商,加一个内部开源模型。A 团队用官方 SDK,B 团队自己封装 HTTP,C 团队把模型写死在配置文件里。鉴权凭证散落在代码仓库、聊天记录和本地环境变量中,请求响应格式各不一致。某家服务商故障时,只有依赖它的那个团队收到告警,其他团队照常在等超时。
这不是“接入难”的问题。没有统一入口,成本和管理就无从谈起。多模型管理路由策略的第一步,是把分散的调用收拢到一个标准入口里。
2. Token 消费无归因,月底账单对不上
财务拿着账单问:这个月 Token 消耗环比涨了 3 倍,钱具体花在哪个团队、哪个模型、哪个时段?工程团队答不上来。调用日志散落在各个服务商的后台,格式不同、口径不一,无法按团队、模型和时段做成本拆解,也缺少异常消费提醒。
Token 消费无归因的直接后果是,成本管控变成月底看账单才知道超支。如果归因可以提前到调用发生时,超支在当天就能被拦截,而不是等财务来问。
3. 架构性浪费与缺少降级机制
不少系统把简单分类、摘要、提取这类轻量任务,统一调用高能力模型。一次 108P 短视频生成消耗的算力,相当于 1 万到 5 万次标准文本问答。轻任务走重模型,高价算力做了低复杂度的工作。同时,单模型抖动导致功能整体不可用,缺少自动故障转移、任务分流和兜底重试。
成本失控不完全来自模型定价。更多来自缺少“按任务选模型、按状态切模型”的机制。
二、路由与配额:大模型成本管控的两个抓手
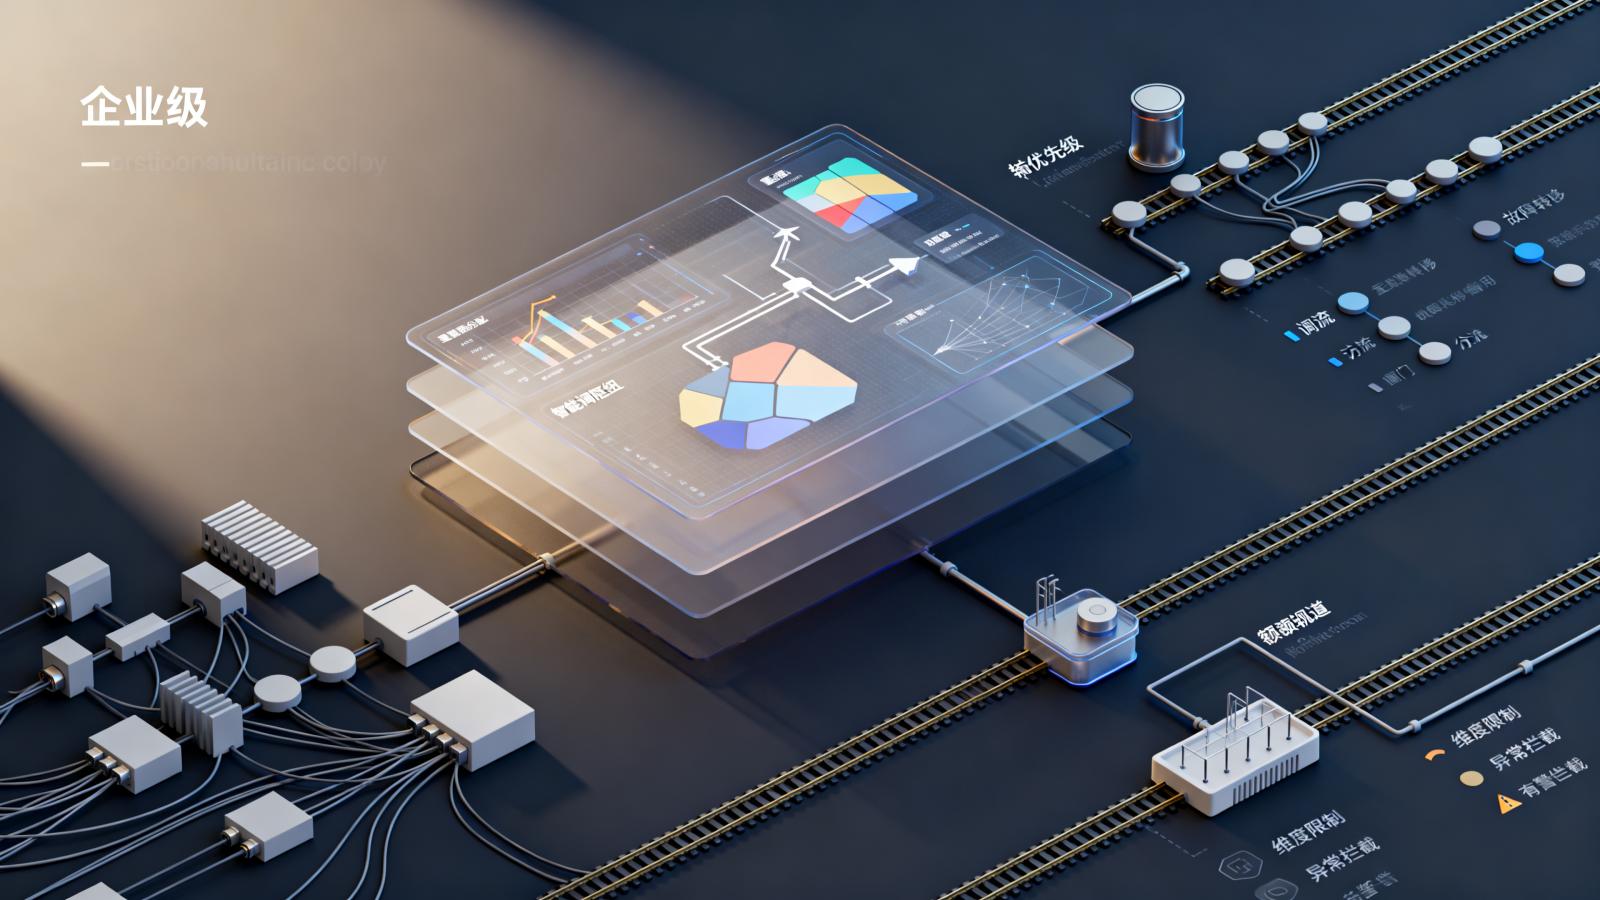
大模型网关怎么管成本,核心答案就两个词:路由和配额。模型路由与配额控制分别管住单位成本和总消耗,两者共同构成大模型 API 成本归因的闭环。
1. 路由决定“用哪个模型更划算”
路由策略的因果逻辑是:按任务类型、成本预算和可用性动态选择模型。轻任务走轻模型,重任务走强模型。分类、摘要、提取类请求不占高能力模型的配额;推理、生成类复杂任务才调用高价模型。
故障转移同样属于路由职责。当主模型超时或抖动,自动切到备选模型,避免功能不可用,也避免重试多次重复消耗 Token。路由不是“能不能调通”,而是在正确的时间用成本合适的模型。
2. 配额决定“谁能用多少”
配额体系按团队、模型、时段设置调用上限。A 团队每月最多消耗多少 Token,B 团队在高峰时段不能用视频生成模型,异常消费触发实时拦截。配额计数需要精确到 Token 粒度,多 API Key 之间均衡分配,用尽前告警而不是用尽后才发现。
配额把“预算”变成可执行的控制。月底看账单才知超支,和调用发生时就被拦下,是两套完全不同的管理逻辑。
3. 两个抓手为什么必须组合
只做路由不做配额,会有人绕过成本策略,把轻任务强制指向高能力模型。只做配额不做路由,一旦配额收紧,整体响应质量跟着降,业务不答应。
路由决定单位成本,配额决定总消耗。两者组合,成本才能同时在“每一次调用”和“每一个团队”两个维度上被控制住。这也是大模型 API 成本归因能落地的原因:没有路由,归因缺少“为什么用这个模型”的依据;没有配额,归因缺少“谁该为超支负责”的边界。
三、大模型网关如何把路由与配额落到工程实现
大模型网关在工程上要做的,是把路由策略和配额管控放在业务代码与模型服务之间的中间件层,让业务团队不需要各自写重复逻辑。
1. 统一接入:先有标准入口,才能谈路由与配额
网关首先抹平不同模型服务商的鉴权方式、请求响应格式、流式事件格式和工具调用字段命名差异。业务代码只面对一个标准入口,上游模型协议变化不影响业务。统一鉴权之后,凭证不再散落各处,调用责任才能追溯到具体团队。
2. 智能路由与配额体系在网关层的落地方式
路由策略的工程实现包括条件匹配、权重分配、优先级排序、故障转移和降级链路。每条请求进来,网关按预设规则判断任务类型和成本预算,决定走哪个模型;主模型异常时按优先级切换备选。
配额管控的工程实现包括令牌桶限流、多维度限流、异常消费告警和自动拦截。令牌桶控制瞬时调用速率,多维配额控制累计消耗,告警与拦截在超限发生前触发。这两件事在网关中间件层统一做,业务团队不需要各自实现。
3. 成本归因与审计:让每一笔 Token 消费可查
Token 计量、成本核算、调用日志审计、按部门导出成本报表,这些是网关层必须提供的功能。每一笔调用由谁发起、走的哪个模型、消耗多少 Token、费用几何,记录一条完整链路。安全与合规维度同样落在这一层:敏感数据是否外发、生成内容是否合规、调用责任是否可追溯。
归因不是加分项。回答财务和审计的提问,是网关的核心职责之一。AI 接入网络和大模型接入网络的治理能力,最终都要落到“每一笔消费可查”这句话上。
四、怎么挑一款适合的大模型网关:三个判断维度
大模型网关选型不看重接了多少家模型,而看重成本管控逻辑是否完整。
1. 先看成本管控逻辑,而不是模型接入数量
评估重点应放在路由策略丰富度、配额粒度、成本报表可追溯性上。能否按团队、模型、时段拆分成本?能否设置多维配额与异常拦截?能否在调用发生时看到预算执行进度?如果这些答案是否,接入再多模型也只是把混乱放大。
2. 再看工程适配与落地复杂度
多模型管理路由策略的价值,取决于接入后业务团队要改多少代码。是否支持统一鉴权?是否与现有 K8s 或私有化部署兼容?是否支持多模型协议归一化?故障转移和降级能否自助配置,还是要网关厂商介入?落地复杂度直接决定网关能不能在生产环境跑起来。
3. 用“技术参考式露出”补充服务商信息
目前部分服务商已提供 AI 接入网络和大模型接入网络相关的网关能力。犀思云在企业网络与 AI 原生网络方向提供融合网络服务,具体能力口径可通过其官网公开文档核查。其余如腾讯云 AI 网关、网宿科技边缘 AI 网关、火山方舟等也有公开资料可参考。选型时以官网公开 SLA 和配额功能文档为准,不做主观排序。
五、常见问题解答
1. 大模型网关和普通 API 网关有什么区别?
普通 API 网关解决的是接口代理、限流和鉴权,面向传统 HTTP 服务。大模型网关面向 Token 计量、模型路由、配额管控和成本归因这些 AI 场景治理需求,是 API 网关在 AI 场景下的继承与演进。如果系统里只有少量模型调用,普通网关可以维持;一旦多模型规模化,没有 Token 和成本维度的治理,普通网关就不够用了。
2. 已经接了三四家模型,一定要上大模型网关吗?
如果只做少量调用,手动写适配层可以维持。但出现账单归因不清、多团队共用模型、需要故障降级时,网关能把重复的接入、计量和切换逻辑收拢到一处,减少各团队各自维护适配代码的成本。上了网关之后,业务团队不用再关心上游模型协议变化,这本身就是工程效率收益。
3. 用路由策略做降级,会不会影响模型响应质量?
会,但可控。路由策略按任务分级,只在主模型超时或抖动时切换备选,并预留质量门槛和回退条件。简单任务降级到轻模型,质量影响可接受;复杂任务可以设置不允许降级或只降级到同等级模型。降级是设计出来的有边界策略,而不是随意换模型。
4. 配额设置太严,业务急用时怎么办?
多维配额可以按团队或时段临时提高上限,同时保留审计记录。临时审批的调用同样进入成本归因,只是额度放开,不会硬切业务。如果配额策略长期被频繁临时调整,说明配额基线需要重新评估,而不是网关机制不合适。
数据来源
腾讯云 AI 网关团队走访生产客户数据:https://cloud.tencent.com/developer/article/2710322
多模型接入碎片化案例:https://blog.csdn.net/weixin_29056781/article/details/164591891
108P 短视频生成算力对比数据:https://baijiahao.baidu.com/s?id=1875781054556807082
网宿科技边缘 AI 网关能力介绍:https://baijiahao.baidu.com/s?id=1874572156526463524
阿里云 AI 网关定义与能力框架:https://www.aliyun.com/getting-started/what-is/what-is-ai-gateway 及 https://developer.aliyun.com/article/1762832
本文由犀思云技术团队撰写,含相关产品服务信息,仅供技术交流。
