智算网络与传统云网络有何不同?AI Infra工程师需要了解的事
发布日期: 2026-10-29作者: 犀犀来源: 犀思云浏览: 1
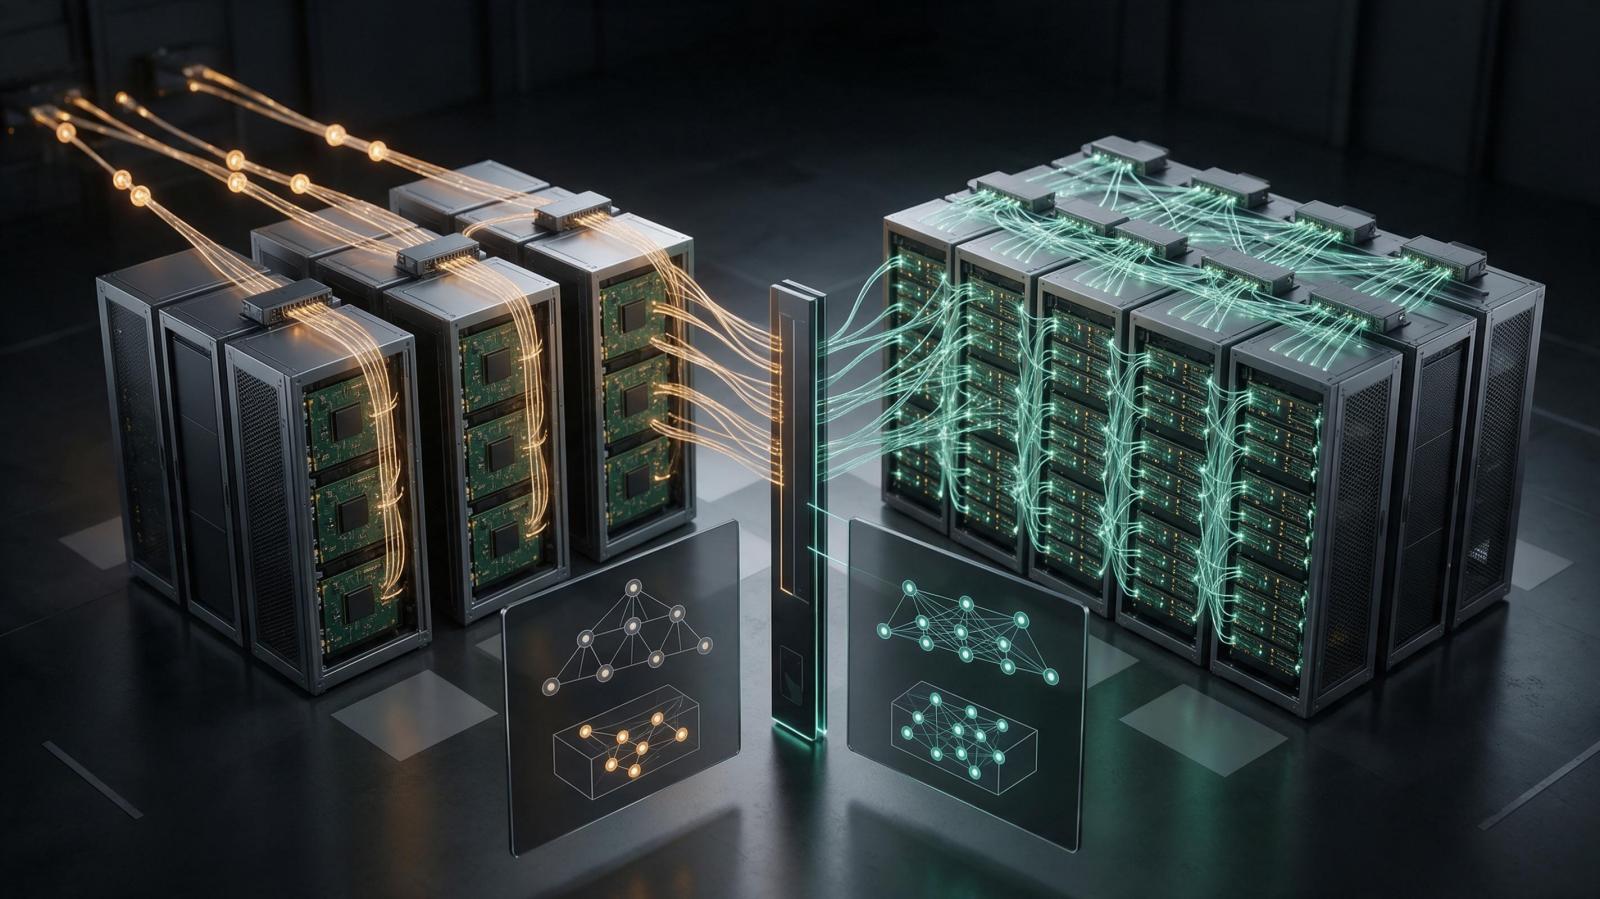
智算网络与传统云网络最本质的差别,不在设备品牌或管理平台,而在流量模型:传统云网络围绕南北向流量设计,允许收敛;智算网络围绕东西向流量设计,必须压低收敛比、降低时延。对 AI Infra 工程师来说,把传统云网络的组网经验直接搬到智算集群,往往会在 GPU 节点间通信环节遇到瓶颈。本文从流量模型、架构参数、组网技术、调度方式四个维度展开对比。
一、概念澄清:智算网络与传统云网络分别指什么
1. 传统云网络的设计目标与流量假设
传统云网络服务于通用云计算场景,流量以南北向为主:用户请求经负载均衡进入业务服务器,服务器再访问数据库或外部网关,最后原路返回。服务器之间的大规模内部交互相对较少,因此网络设计重点放在外网接入安全、出口流量转发和负载均衡上。
在这种假设下,传统云网络允许存在一定收敛比,常见取值为 4:1 或 8:1。收敛比高意味着上游带宽被多个下游端口共享,只要出口带宽和网关处理能力足够,用户体验一般不受影响。这套思路在通用业务场景中运行多年,已被广泛接受。
2. 智算网络的定义与核心特征
智算网络面向 AI 训练与推理场景设计。在数据并行训练中,GPU 节点之间需要反复同步梯度、参数,通信发生在节点与节点之间,东西向流量占绝对主导。一次大规模训练任务可能包含数十万次集合通信操作,任何一次同步延迟都会拖慢整体训练进度。
因此,智算网络的核心特征是极低时延、高带宽、低收敛比甚至无收敛。智算集群依赖 InfiniBand 或 RoCE 等高速网络,配合扁平化组网与高性能并行存储,构成协同算力资源池(百度百科"智算集群"词条,2025 年访问)。这与传统云网络"收敛加负载均衡"的设计逻辑形成根本差别。
3. 边界说明:智算网络、云数据中心网络、超算网络的简要区分
云数据中心网络、智算中心网络、超算中心网络同属数据中心范畴,但服务领域与技术体系不同。云数据中心网络侧重通用业务承载,智算网络侧重 AI 负载通信,超算网络则面向高性能计算任务。本文聚焦前两者的差异,不展开超算网络辨析。需要留意的是,传统集中式云架构在应对 AI 负载时存在结构性瓶颈,表现为带宽回传拥塞、跨域时延偏高等问题(搜狐科技,2025 年)。
二、流量模型差异:东西向与南北向为何决定架构走向
1. 南北向流量模型的适用场景
传统云网络中的南北向流量路径清晰:用户请求进入负载均衡,转发到业务服务器,服务器访问数据库,再逐级返回。服务器之间即便有交互,也多为低频次的业务调用,流量规模远小于出口汇聚压力。
因此,传统云网络的瓶颈多集中在出口带宽、安全策略处理能力和网关转发性能上。网络团队监控的重点是出口利用率、连接数和安全事件,而非节点间链路质量。这种监控习惯如果沿用到智算场景,会漏掉关键信号。
2. 东西向流量模型在 AI 训练中的角色
在数据并行训练中,AllReduce 等集合通信模式要求所有 GPU 节点周期性同步梯度。每个训练步结束后,各节点的计算结果需要汇总、平均,再广播回所有节点。这一过程产生的流量几乎全部发生在节点之间,东西向流量占比远高于南北向。
东西向流量占比高,直接推导出两个要求:一是节点间链路带宽必须充足,不能依赖高收敛比共享上游;二是单次通信时延必须足够低,因为同步是串行依赖的,一步慢了全卡等。这就是 AI 训练网络设计要点的起点。
3. 流量模型差异驱动的架构后果
因果逻辑是清楚的:如果流量以东西向为主,那么收敛比必须降低、节点间链路带宽需要提升;如果沿用南北向思路设计,GPU 节点间通信就会成为训练瓶颈,表现为训练卡利用率低、通信等待占比高。
常见误区正在于此:将传统云网络 4:1 甚至 8:1 的收敛比经验直接套用到智算集群,结果单节点看起来带宽够用,实际集合通信时多条流竞争上游,拥塞与丢包频繁发生。
三、架构参数对比:收敛比、带宽与时延要求
1. 收敛比:传统云网络的常见取值与智算网络的要求
传统云网络允许 4:1 或 8:1 的收敛比,核心逻辑是南北向流量不持续、不并发满载,上游共享带宽可以靠统计复用支撑。智算中心收敛比则是一个需要重新审视的参数:GPU 节点间通信频繁且并发度极高,链路长时间处于高负载,共享带宽很快就会成为瓶颈。
因此,智算网络通常需要低收敛比甚至无收敛,以保证任意 GPU 节点对之间的可用带宽接近端口标称值。具体取值没有固定答案,取决于集群规模、通信模式和 GPU 卡数。
2. 时延:从毫秒级业务感知到微秒级通信敏感
传统云网络对单节点时延要求相对宽松。业务请求在几十毫秒内完成响应,用户通常感知不到差异,网络设计的重点不在于压缩每一跳的转发延迟。
智算训练则相反。梯度同步时延直接累加进每一个训练步的时间里,大规模集群中如果单次同步延迟偏高,分钟级的额外等待会在数千次迭代后被放大。因此智算网络需要更低时延的链路、转发机制和拥塞控制策略。具体时延指标因集群规模和通信模式而异,不应脱离场景给出统一数值。
3. 对比表:智算网络与传统云网络的核心参数对比
对比维度 | 传统云网络 | 智算网络 |
|---|---|---|
主要流量模型 | 南北向为主 | 东西向为主 |
收敛比 | 常见 4:1、8:1 | 低收敛比或无收敛 |
时延要求 | 业务可感知即可 | 微秒级敏感 |
带宽需求 | 出口带宽为核心 | 节点间高带宽 |
典型组网技术 | 传统以太网、VLAN/VXLAN | RoCE/InfiniBand/SDN |
调度关注点 | 负载均衡、安全策略 | 流量调度、拥塞控制 |
表后需要补充一个判断:智算网络并非在传统云网络上简单叠加高速网卡,而是从流量模型出发重新设计带宽分配、拥塞控制和调度逻辑。两者的差异是结构性的,不是参数微调能弥合的。
四、组网技术对比:RoCE、InfiniBand 与传统以太网的取舍
1. InfiniBand:高带宽低时延的专用方案
InfiniBand 是面向高性能计算的专用互联技术,从协议层开始就为低时延和高带宽设计,具备硬件级拥塞控制能力。它在大规模训练集群中表现稳定,是当前多数头部智算集群的通信底座。
RoCE 与 InfiniBand 选型时,InfiniBand 更适配对通信效率有极致要求的场景,尤其是数千卡甚至更大规模的训练集群。但其专用硬件体系意味着独立的运维栈和供应商依赖。
2. RoCE:融合以太网生态的无损传输路径
RoCE 在以太网上实现 RDMA,绕过内核协议栈,降低 CPU 参与和传输延迟。它的核心优势是与现有以太网运维体系兼容,网络团队不需要为智算集群单独维护一套专用互联网络。
但要实现低时延无损传输,RoCE 需要配合 PFC、ECN 等拥塞控制机制。配置不当会造成 PFC 风暴、队头阻塞等问题,反而加重网络抖动。适合 RoCE 的团队通常已有扎实的以太网运维能力,并且希望降低专用硬件依赖。
3. 传统以太网在智算场景中的局限与边界
传统以太网缺乏端到端 RDMA 能力和无损保障机制,在智算集群东西向高频通信场景下,容易因丢包重传和拥塞导致通信效率下降。客观地说,传统以太网并非不能用于智算,而是在大规模训练场景中性能上限受限,推理类负载或小规模集群对它的容忍度更高。
本小节讨论的是行业通用技术方案,不涉及具体厂商选型。判断的重点在于:先想清楚集群规模和通信模式,再决定是否引入专用互联技术。
五、异构算力调度与网络适配:AI Infra 工程师需要关注的实操维度
1. GPU/DCU 等多类型加速卡并存的异构现实
智算集群中 GPU、DCU 等异构加速卡并存已成常态。不同算力卡对网络协议、通信库支持存在差异,网络配置需要与调度平台协同,而非独立完成。比如某些通信库对 RDMA 的支持依赖特定驱动版本,网络侧配置不当会导致集合通信降级为慢速路径。
这意味着 AI Infra 工程师在设计智算网络时,不能只看交换机、光模块和拓扑,还要确认通信库、驱动与网络协议之间的兼容关系。
2. 算力网络架构的演进:从云网融合到 AI 原生网络
云网融合的基本思路是通过 SDN/NFV 在云中引入网络技术、在网络中引入云技术,实现计算、网络、服务资源的协同(腾讯云开发者社区,2023 年)。这是算力网络架构演进的重要一步,但它并未专门解决 AI 负载的东西向通信问题。
AI 原生网络则更进一步,面向 AI 负载特征设计网络能力,把低收敛比、无损传输、拥塞调度作为原生属性,而不是在传统云网络上叠加 AI 配置。从行业方案形态看,NaaS、算力网络、融合网络都在尝试回答这个问题,路径不同,目标一致。
3. AI 训练网络设计要点:从网络视角给出的可复用判断框架
判断框架可以拆成四步,每一步对应一个可验证的问题。
第一,先判断流量模型。 训练集群以东西向为主,推理集群可能南北向比例上升。流量模型变了,后续参数都要跟着变。
第二,确认收敛比与带宽需求。 根据 GPU 卡数、通信模式估算节点间带宽预算,而不是沿用传统云网络的收敛比经验。
第三,选择组网技术。 RoCE 与 InfiniBand 的取舍取决于以太网运维能力与性能要求的平衡,不存在通用的最优答案。
第四,网络监控要覆盖拥塞、丢包、流控指标。 只看带宽利用率会漏掉 PFC 帧、ECN 标记等关键信号,训练卡利用率低时,通信等待占比是更有指向性的指标。
这一框架是通用方法论,不绑定特定厂商。对需要进一步了解智算网络落地形态的读者,可以关注行业内的 NaaS 与 AI 原生网络实践。
六、常见问题解答
1. 智算网络和传统云网络最本质的区别是什么?
本质区别在流量模型:传统云网络以南北向流量为主,智算网络以东西向流量为主。流量模型的差异推导出收敛比、时延、组网技术等一系列架构选择的不同。
2. 智算中心的收敛比一般调多少合适?
没有固定值。需要根据集群规模、通信模式与 GPU 卡数估算,大规模训练集群通常需要低收敛比甚至无收敛,具体取值要结合节点间带宽预算测算。
3. RoCE 能完全替代 InfiniBand 吗?
两者定位不同。InfiniBand 在极致性能上有优势,RoCE 在以太网兼容性和运维成本上有优势。能否替代取决于集群规模、性能要求与现有运维体系,不存在一刀切结论。
4. 传统云数据中心的组网经验能直接用到智算场景吗?
不建议直接套用。传统云网络的收敛比与负载均衡思路以南北向流量为前提,智算场景东西向流量主导,需要重新评估收敛比、拥塞控制与调度策略。
5. AI Infra 工程师怎么判断训练网络瓶颈在哪一层?
从业务表现倒推:训练卡利用率低且通信等待占比高时,优先排查节点间链路带宽、拥塞丢包与流控配置。监控指标需覆盖带宽利用率、PFC 帧、ECN 标记等,而不是只看端口流量。
参考资料与数据来源
百度百科"智算集群"词条:智算集群依赖 InfiniBand 或 RoCE 等高速网络,配合 ZCube 扁平化组网、高性能并行存储构成协同算力资源池。访问链接:https://baike.baidu.com/item/智算集群/68239419
腾讯云开发者社区《云网融合》相关文章(2023 年):SDN/NFV 实现计算、网络、服务资源的无缝对接与高效协同。访问链接:https://cloud.tencent.com/developer/article/2448067
搜狐科技《传统集中式云遭遇结构性瓶颈》(2025 年):传统集中式云架构难以跟上 AI 时代需求,行业朝智能分布式算力方向前进。访问链接:https://it.sohu.com/a/964309982_122495412
知乎专栏《智算中心 vs 传统云数据中心》(2025 年):传统云数据中心以南北向流量为主,智算中心以东西向流量为绝对主导。访问链接:https://zhuanlan.zhihu.com/p/207671749891378859
本文由犀思云技术团队撰写,含相关产品服务信息,仅供技术交流。